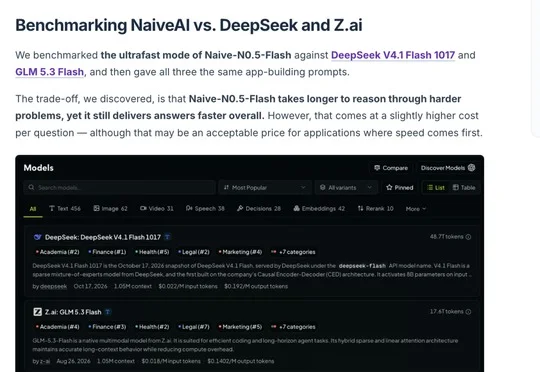
国产大模型又杀出一匹黑马,引发硅谷关注!
国产大模型又杀出一匹黑马,引发硅谷关注!Latent Space实测显示,NaiveAI开源模型Naive-N0.5-Flash综合能力介于DeepSeek V4.1 Flash 1017与GLM 5.3 Flash之间,编程单项评测反超,峰值速度约2100 Token/s,3D太阳系任务表现最佳。
来自主题: AI资讯
7741 点击 2026-11-14 12:48

 搜索
Latent Space实测显示,NaiveAI开源模型Naive-N0.5-Flash综合能力介于DeepSeek V4.1 Flash 1017与GLM 5.3 Flash之间,编程单项评测反超,峰值速度约2100 Token/s,3D太阳系任务表现最佳。
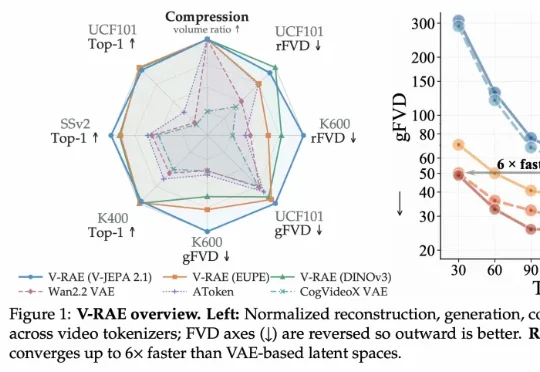
近日,新加坡国立大学 Minghui Guo 与牛津大学 Shengqiong Wu、Hao Fei 在论文《V-RAE: Rethinking Video Latent Spaces for Generation》中提出视频表征自编码器 V-RAE。该方法以冻结的视觉基础模型为编码器,通过轻量级时间池化压缩视频特征,并将具有丰富语义和时间连续性的表征直接用于视频重建、生成与未来预测。
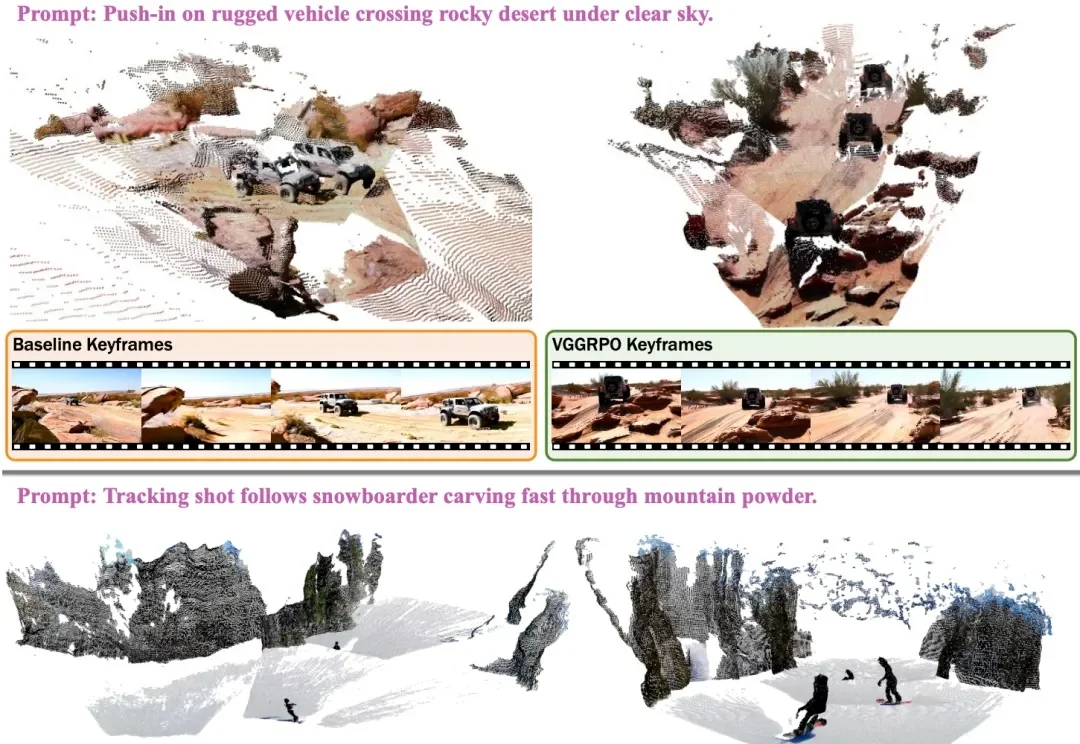
大规模视频扩散模型,画面越来越真,却总在“物理定律”上栽跟头。
最近,来自 Google、哥本哈根大学、牛津大学等机构的研究者提出了 VGGRPO(Visual Geometry GRPO,收录于 ECCV 2026)。这项工作聚焦于一个核心问题:如何在不牺牲预训练模型泛化能力的前提下,高效地提升视频生成的几何一致性,并使其适用于动态场景。其核心思路是,在隐空间(latent space)中利用 4D 几何奖励,进行几何感知的视频后训练。
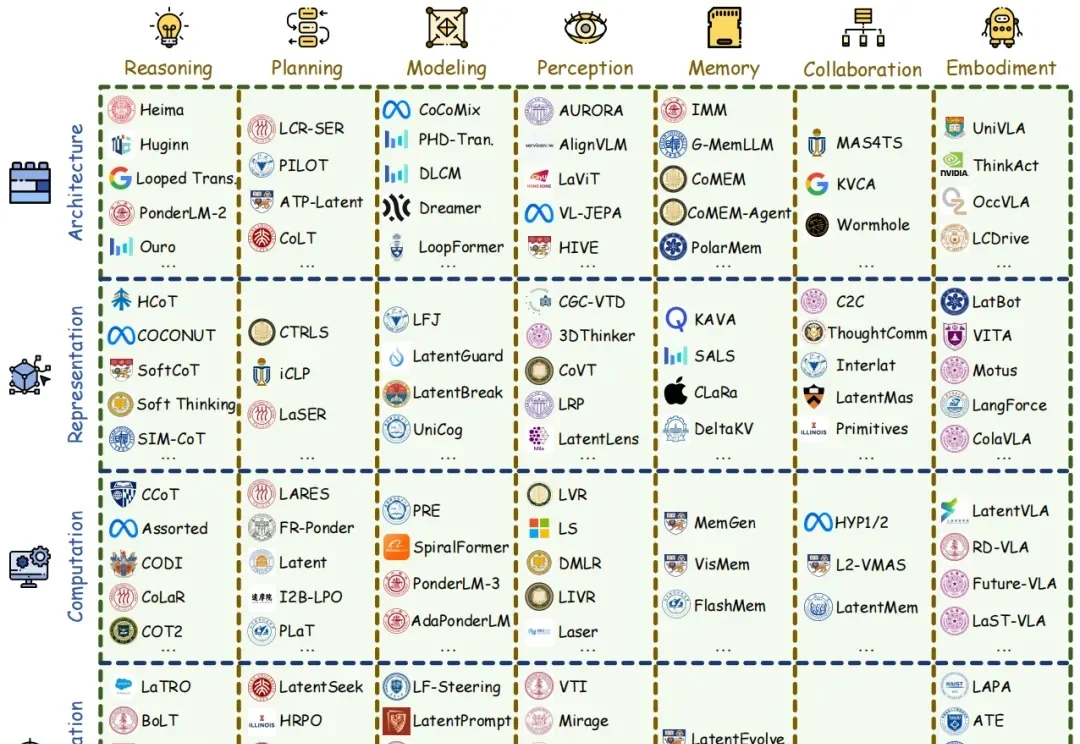
从 2024 年底的关于潜在空间的早期探索,再到 2025 年底和 2026 年初的相关研究爆发,潜空间范式正在彻底重塑大模型 (LLMs, VLMs, VLAs 等延伸模型) 的底层设计逻辑。
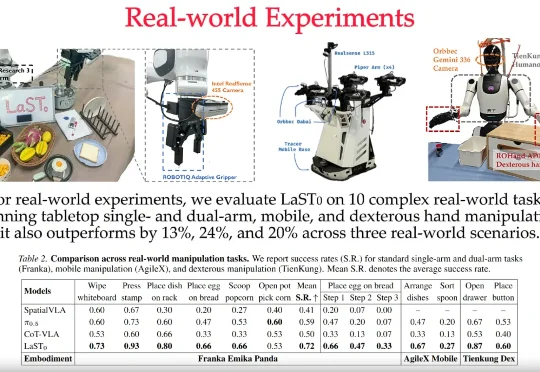
LaST₀团队 投稿 量子位 | 公众号 QbitAI 近日,至简动力、北京大学、香港中文大学、北京人形机器人创新中心提出了一种名为LaST₀的全新隐空间推理VLA模型,在基于Transformer混
最近,Latent Space发布的播客节目中请来了Meta的AI科学家Thomas Scialom。他在节目中揭秘了Llama 3.1的一些研发思路,并透露了后续Llama 4的更新方向。
在生成式模型的迅速发展中,Image Tokenization 扮演着一个很重要的角色,例如Diffusion依赖的VAE或者是Transformer依赖的VQGAN。这些Tokenizers会将图像编码至一个更为紧凑的隐空间(latent space),使得生成高分辨率图像更有效率。
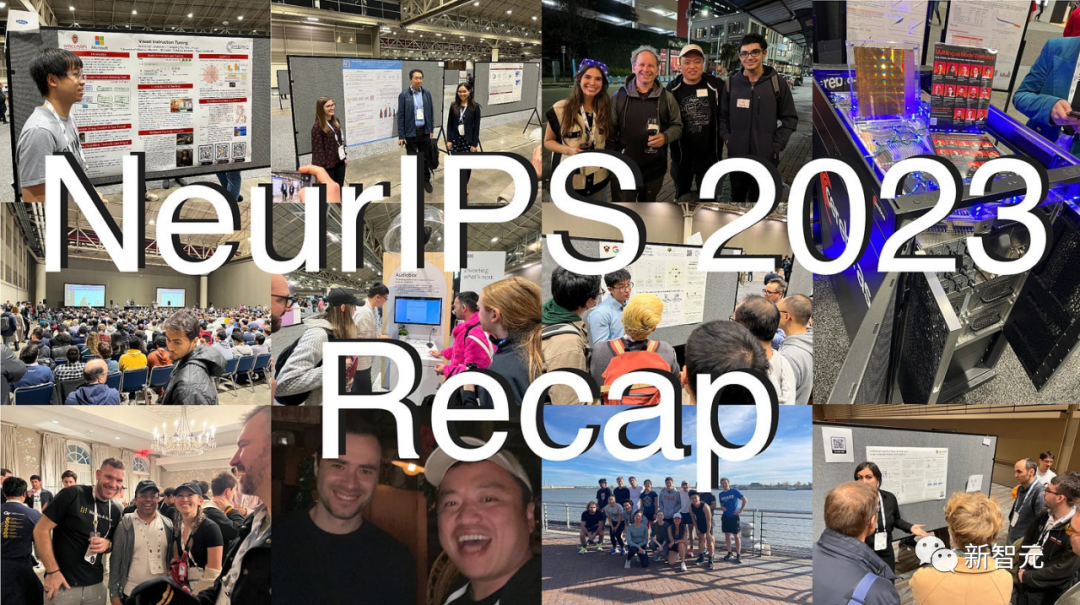
美国著名科技播客Latent Space对于刚刚过去的NeurIPS 2023上的精彩论文进行了一个全面的总结,回顾了多篇优秀论文,虽然没有获奖,但同样值得学界关注。